Serveurs MCP - Introduction & Guide
Dans cet article, j'explique le fonctionnement des MCP (Model Context Protocols), et comment les intégrer à vos IDE pour connecter des outils externes à votre agent, lui fournir du contexte et des leviers d'actions pour réduire les tâches redondantes -> Votre IDE devient un véritable outil tout-en-un.
Résumer avec l'IA :
En 2023, Anthropic a publié le Model Context Protocol (MCP), une norme ouverte souvent décrite comme un « USB-C universel pour l’IA ». Ce protocole permet aux systèmes d’IA de se connecter à des outils externes, des API et des sources de données, de manière bidirectionnelle.
Mon avis sur les MCP :
Les MCP peuvent utiliser n’importe quel service externe.
Est-ce que ça veut dire qu’on va créer des services uniquement pour cette interface ? Non, ça ne remplace pas les API ni les interfaces graphiques.
Par contre, c’est un grand + pour faire marcher les services ensemble et ça rend l’expérience développeur bien meilleure dans les IDE qui supportent les MCP.
N’importe quels outil peut être utilisé par une IA.
La norme MCP pose un cadre aux interactions possibles entre l'outil et l'IA. Un MCP donne à l'IA un catalogue d'outils mis à disposition, parmi lesquels elle n'a plus qu'à choisir pour résoudre le problème qu'on lui pose.
Prenons un exemple; vous êtes développeur et avez une vingtaine de tâches à résoudre, toutes référencées dans Jira.
Vous demandez à l’agent de votre IDE:
Récupère les tâches Jira du projet en-cours, définis moi les priorités pour aujourd’hui.
Définis moi un plan d’action pour chaque priorité, et enregistra ça dans tasks.md
Vous modifiez le plan d’action généré, puis écrivez:
Réalise la tâche X à partir du plan d’action dans @tasks.md
Mets à jour le status des tâches réalisées dans @tasks.md et résume les modifications faites
On s’intéressera principalement à l’usage des serveurs MCP par les agents LLM (chatbots), bien qu’ils puissent être utilisés par n’improte quelle IA.
Comment fonctionne un Large Language Model?
L'utilisateur fournit au LLM un prompt sous forme de texte, qui est ensuite tokenizé, c'est à dire divisé en unités de mot réduites (tokens), puis passé à un modèle. Le modèle est entraîné sur des millions, voire milliards de cas d'usages afin de pouvoir prédire la réponse à une question en se basant sur le contexte qui lui est passé.
Quels MCP utiliser?
Il en existe pour tous les usages. J’utilise principalement les suivant, mais vous pouvez retrouver une liste complète sur le repository awesome-mcp-servers.
| MCP | Usage |
|---|---|
| filesystem | Lire, créer, modifier, chercher des fichiers et répertoires |
| sequentialthinking | Raisonnement structuré sur plusieurs étapes |
| memory-bank-mcp | Mémoire centralisée, fonctionnement multi-projets |
| github | Récupérer les github issues et gérer les pull requests. → rdv en fin d’article pour intégrer ce MCP |
| google calendar | Lister vos disponibilités sur la semaine en cours par exemple → rdv en fin d’article pour intégrer ce MCP |
| tavily | Rechercher des informations factuelles sur le web. Vous avez 1000 recherches gratuites par mois |
| fetch | Extraire des données structurées depuis des APIs web |
| firecrawl | Crawler à usage général pour récupérer des pages web. L’offre gratuite offre jusqu’à 500 scrapes → rdv en fin d’article pour intégrer ce MCP |
| playwright | Automatiser des tâches sur un navigateur web |
| shadcn | Intègre les composants de la librairie shadcn en éliminant les hallucinations sur les props |
J’ai testé le MCP Figma-Context-MCP pour convertir des maquettes Figma en composants React, mais le résultat n’a pas été concluant (pour dire peu).
Pour ceux qui souhaitent transformer un design en code, une approche alternative existe, même si je ne la recommande pas particulièrement :
- Capturer la maquette.
- Utiliser un LLM pour décrire les typographies, couleurs et espacements, en se basant sur une grille de 12 colonnes (desktop), 8 colonnes (tablette) et 4 colonnes (mobile).
- Générer ensuite la page React ainsi que le design system associé, avec shadcn et Tailwind.
Security risks regarding MCP usage
When you run an MCP server locally, it’s just like running any other software, with full access to all your files.
Instead of running them directly, MCP servers should be containerised and run in Docker with restricted access:
- to the filesystem by running as a non-root user
- to memory and CPU, for example in docker-compose:
12345deploy: resources: limits: cpus: '0.001' memory: 50MRisques de sécurité liés à l’utilisation des MCP
Lorsque vous exécutez un serveur MCP en local, c'est exactement pareil que lorsque vous exécuter n'importe quell application tierce, en lui donnant un accès illimité à tous vos fichiers.
Au lieu de les exécuter nativement, les serveurs MCP doivent être conteneurisés et lancés via Docker avec un accès restreint :
- au système de fichiers, en utilisant un utilisateur non-root.
- à la mémoire et au CPU, par exemple dans docker-compose :
12345deploy: resources: limits: cpus: '0.001' memory: 50MJe vais bientôt rédiger un guide sur l’utilisation de Docker, n'hésitez pas à consulter ce guide centré sur la sécurité: MCP-Checklists
Focus sur les MCP web: Fetch vs Firecrawl vs Browserbase vs StageHand vs PlayWright
- Besoin de récupérer le contenu de sites en ligne?
→ Utilisez Firecrawl, un crawler abstrait auquel on peut passer des règles pour le guider. C'est une technologie open-source basée sur un navigateur sans têteheadlesscloud que l'on peut soi-même héberger. Firecrawl charge le site, exécute le javascript, obtient le contenu dynamique chargé côté client, ce dont Fetch n'est pas capable.
→ Pas d’automatisation de navigateur car n’interagit pas avec la page
→ S’exécute dans le cloud et peut être intégré aux pipelines CI/CD - Besoin d’automatiser des actions dans un navigateur cloud?
Pour vos environnements CI/CD, utilisez Browserbase et Stagehand pour interagir avec des sites.Quelle est la différence entre Broserbase et stagehand?
Browserbase estimpératif, il faut lui dire les étapes à réaliser pour atteindre le but recherché. Stagehand, lui, estdéclaratif. Il suffit de lui donner le résultat à atteindre pour qu'il trouve le moyen d'y parvenir. - Besoin de crawl/interagir avec un site local ou qui nécessite de s’authentifier?
Deux outils peuvent vous servir: Puppeteer et Playwright. Ils s’exécutent tous deux en modeheadfuletheadless, c'est à dire avec ou sans visuel. En mode headful, le navigateur s'ouvre et vous pouvez visualiser les interactions opérées par le MCP.
→ Privilégiez Playwright. Il utilise le navigateur local avec la session utilisateur actuel, parfait pour accéder à un site ou il faut sauthentifier.Les sessions Playwright peuvent être isolées en utilisant l'argument
--isolated, cf. la page github de Playwright.
Configurer les MCP sur Cursor
Connecter le serveur MCP Firecrawl
Objectif: Crawler des sites web publics anonymes.
- Allez sur https://www.firecrawl.dev/
- Créez un compte avec le Free plan qui coffre jusqu'à 500 scrapes.
- Copiez la configuration MCP
Sur la droite du dashboard, dans la section API key, sélectionner MPC Integration avec la version la plus récente de Cursor: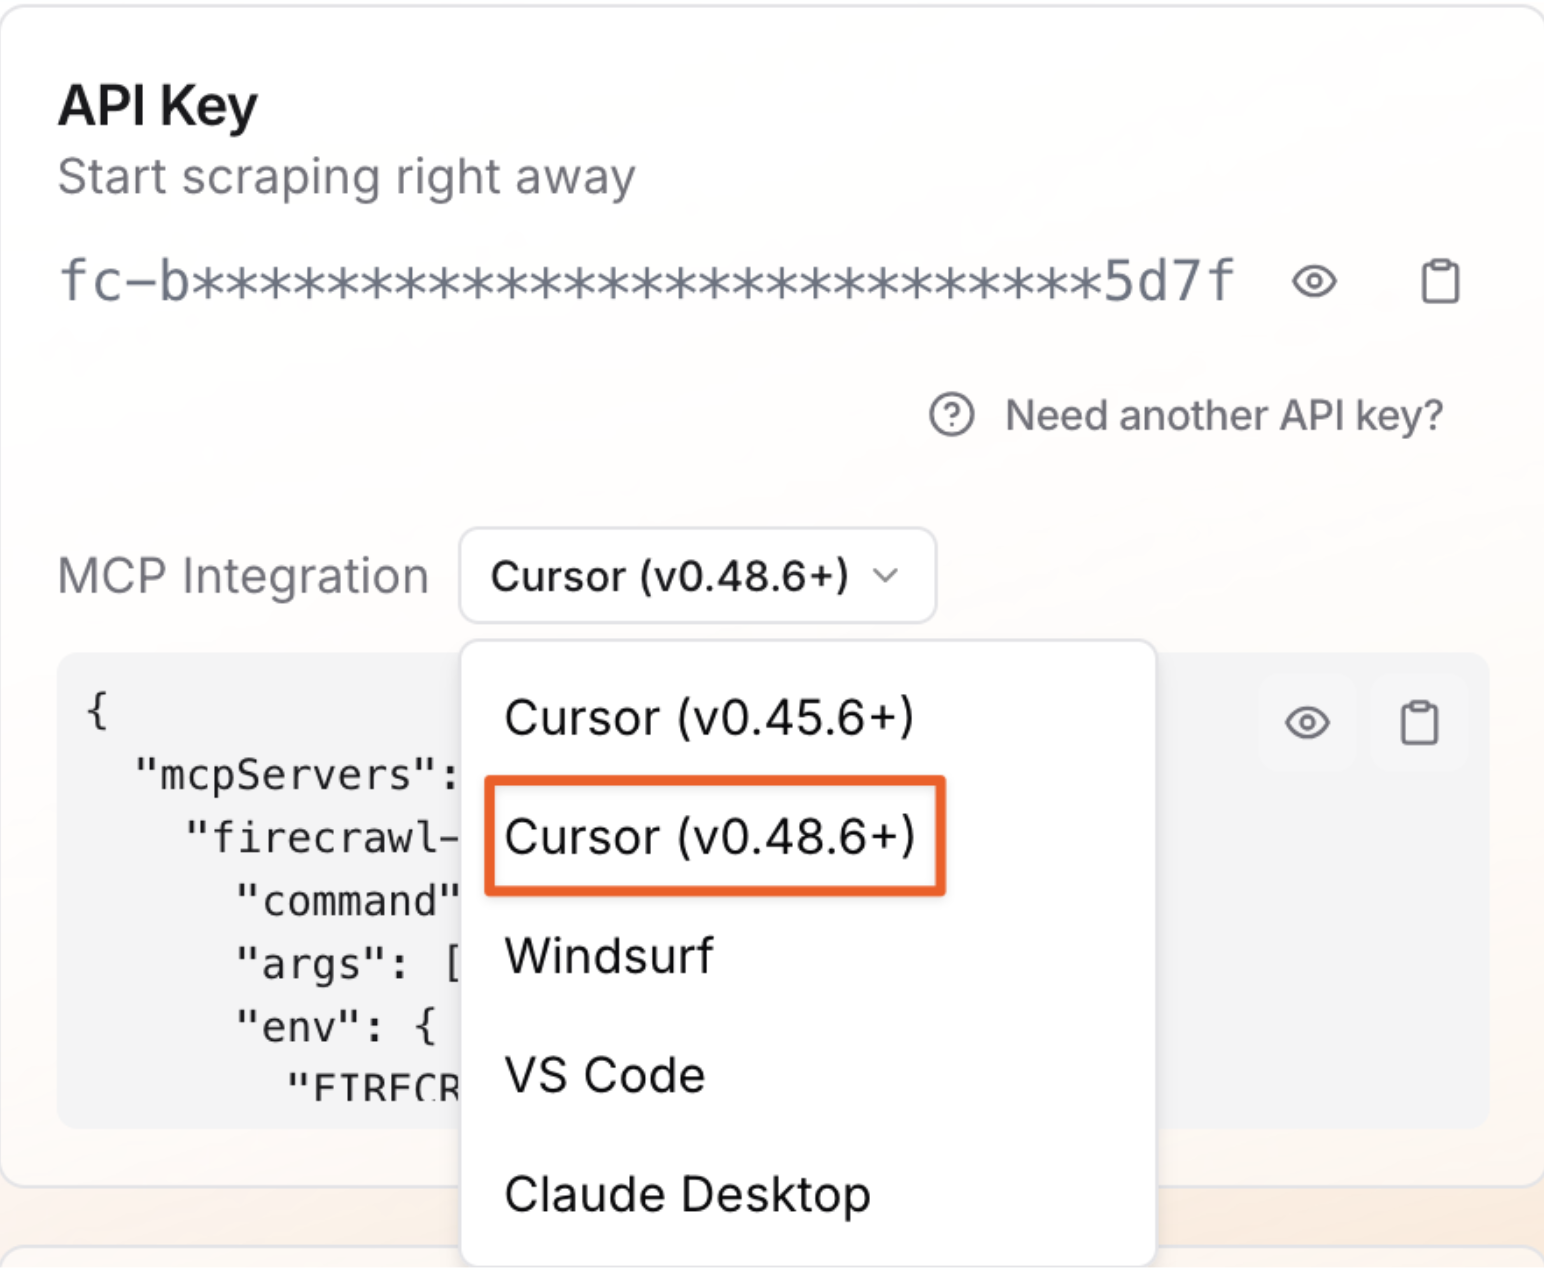
- Coller la configuration dans Cursor
Allez dans Cursor settings > MCP > Add a new MCP, et collez la configuration.
Connecter le serveur MCP GitHub
Objectif: Accéder aux GitHub issues et gérer vos pull requests.
- Ajouter la configuration suivante dans votre fichier :
1234567"github": { "command": "npx", "args": ["-y", "@modelcontextprotocol/server-github"], "env": { "GITHUB_PERSONAL_ACCESS_TOKEN": "<YOUR_GITHUB_PERSONAL_ACCESS_TOKEN>" }}- Obtenir un Personal Access Token en allant sur GitHub
- Créer un nouveau fine-grained token avec les permissions suivantes sur tous les dépôts (ou sur les dépôts spécifiques à accéder) :
- Commit statuses : Lecture et écriture
- Contents : Lecture et écriture
- Issues : Lecture et écriture
- Merge queues : Lecture et écriture
- Metadata : Lecture seule
- Pull requests : Lecture et écriture
- Secret scanning alerts : Lecture seule
- Events : Lecture seule
Connecter le serveur MCP Google Calendar
Objectif: Lister facilement vos disponibilités
- Créer un nouvel identifiant client OAuth et un secret client dans la Google Cloud Console.
- Aller dans API & Services > Identifiants > Créer un ID OAuth.
- Sélectionner Application de bureau (Desktop app).
- Télécharger le fichier d’identifiants et l’enregistrer sous le nom credentials.json à la racine du dépôt google-calendar-mcp.
- Dans Accès aux données, cliquer sur Ajouter ou supprimer des niveaux d’accès.
- En bas, dans la section Ajouter manuellement des niveaux d’accès, saisir :
https://www.googleapis.com/auth/calendar.events - Pour se connecter à un projet non validé en phase de test, utiliser des utilisateurs test :
- Aller dans Audience > Utilisateurs test
- Cliquer sur Ajouter un utilisateur et entrer votre email.
- Cloner le dépôt :
git clonehttps://github.com/nspady/google-calendar-mcp.git - Aller dans le répertoire cloné :
cd google-calendar-mcp - Installer les dépendances :
npm install - Construire le projet :
npm run build - Lancer l’authentification :
npm run authLe MCP demandera une ré-authentification chaque semaine.
- Ajouter le MCP à la configuration :
1234"google-calendar": { "command": "node", "args": ["<absolute path to /google-calendar-mcp/build/index.js"]},Récap
Les MCPs c’est un standard qui apporte une interopérabilité forte entre IA et services externes pour:
- Enrichir vos environnements de développement
- Enrichir vos workflows y connectant des outils externes
L’installation se fait facilement, et notre agent se transforme en hub intelligent.
Est-ce que vous ressentez aussi un gain de temps grâce aux MCP?
Si oui, quels serveurs MCP trouvez-vous vraiment pertinants?
Table of Contents
- N’importe quels outil peut être utilisé par une IA.
- Quels MCP utiliser?
- Security risks regarding MCP usage
- Risques de sécurité liés à l’utilisation des MCP
- Focus sur les MCP web: Fetch vs Firecrawl vs Browserbase vs StageHand vs PlayWright
- Configurer les MCP sur Cursor
- Connecter le serveur MCP Firecrawl
- Connecter le serveur MCP GitHub
- Connecter le serveur MCP Google Calendar
- Récap
Comments (0)
No comments yet. Be the first!